
ChatGPT si ricorda di noi?
In breve
Una nuova chat con ChatGPT non è necessariamente una pagina bianca. Il sistema può portare nella conversazione presente elementi delle interazioni precedenti, costruendo nel tempo una continuità che è però selettiva, parzialmente controllabile e non del tutto trasparente. Non ricorda tutto, non utilizza sempre ciò che ha conservato e i criteri con cui alcune informazioni riemergono mentre altre no rimangono in parte opachi. La sua memoria non è quindi assimilabile a quella umana, ma produce per l’utente un effetto molto concreto: ciò che ChatGPT ci risponde oggi può essere influenzato dalla storia delle nostre interazioni con lui
Volevo dimostrare che l’IA scrive quello che vuoi tu
Volevo fare un esperimento per dimostrare una mia convinzione: volendo, e soprattutto sapendolo fare, l’IA scrive quello che vuoi tu e come vuoi tu.
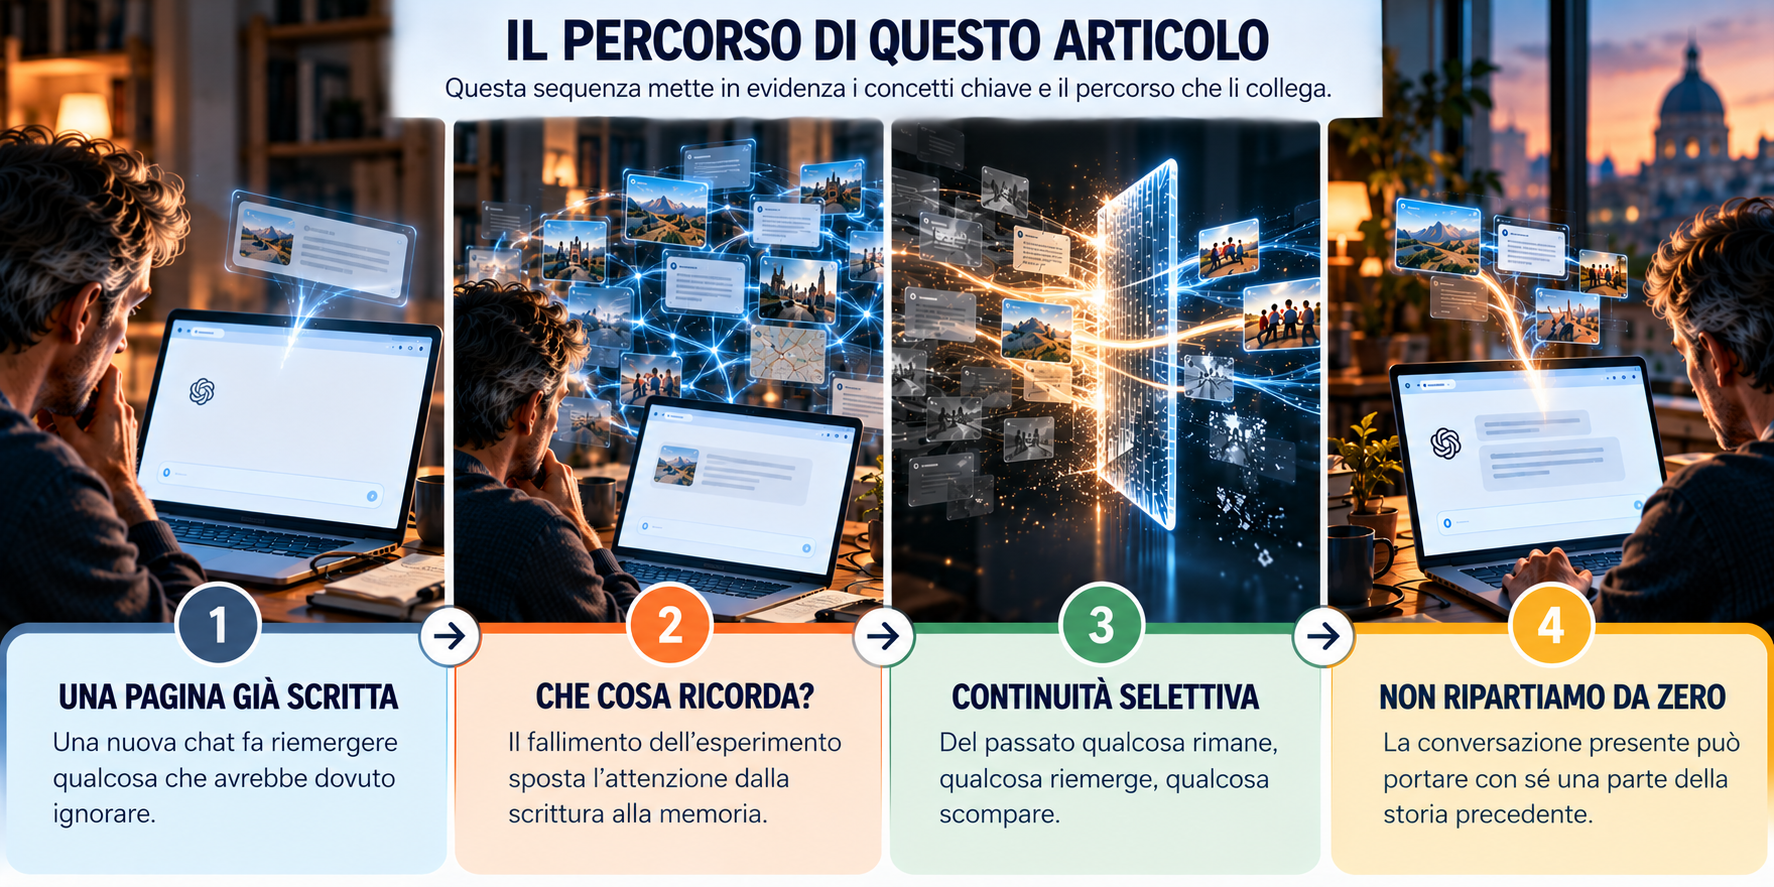
L’esperimento è fallito.
Ma sono abbastanza certo che, prima o poi, riuscirò a dimostrare la mia tesi.
Veniamo ai fatti.
Gli articoli che pubblico in questo blog non vengono prodotti chiedendo a un’intelligenza artificiale: «Scrivimi un articolo su questo argomento». Nascono attraverso un processo molto più lungo.
Si parte spesso da un’idea ancora poco definita, da una domanda, qualche volta da un’affermazione che voglio mettere alla prova. Ne parlo con ChatGPT. Arriva una prima risposta. Qualcosa mi convince, qualcosa no. Obietto. Chiedo di approfondire un punto, ne elimino un altro, introduco una distinzione che mi sembra necessaria. ChatGPT propone una formulazione diversa o porta nella discussione un aspetto che non avevo considerato. A volte lo accolgo, altre volte lo contesto. Una risposta genera una nuova domanda e quella domanda modifica il problema dal quale eravamo partiti.
Si procede così, avanti e indietro, anche per parecchio tempo.
Non è quindi un processo nel quale io ho già l’articolo in testa e utilizzo l’IA semplicemente per trasformarlo in una versione pubblicabile. Ma non è neppure un processo nel quale ChatGPT scrive e io mi limito ad approvare ciò che produce.
L’articolo prende forma durante l’interazione.
Alla fine può essere difficile persino stabilire a chi sia venuta per primo una determinata formulazione. Ed è una domanda che mi interessa relativamente. Quello che mi interessa è un’altra cosa: quando l’articolo è terminato, pur essendo stato redatto a “quattro mani” lo sento mio, mi riconosco nel ragionamento e sono in grado di darne ragione. È questo il criterio di autorialità che utilizzo.
Proprio questa modalità di lavoro mi aveva fatto venire una curiosità.
Quanto di ciò che caratterizza questi articoli dipende dall’interazione? Cosa farebbe l’IA lasciata lavorare senza vincoli e interazione?
Per scoprirlo volevo prendere un argomento sul quale avevamo già lavorato a lungo e fare esattamente il contrario: chiedere l’elaborazione di un articolo, niente discussione, niente obiezioni, niente correzioni, niente indicazioni sul modo in cui affrontarlo.
Soltanto un tema.
Poi avrei confrontato i due articoli, quello “in purezza” di ChatGPT e quello frutto dell’intenso lavoro collaborativo.
Per evitare che ChatGPT recuperasse il lavoro precedente, ho aperto una nuova conversazione, fuori dal progetto nel quale lavoriamo abitualmente. Pensavo fosse sufficiente: una chat nuova, un prompt essenziale, nessun riferimento a quello che avevamo già scritto.
Ho scelto proprio un argomento sul quale il confronto sarebbe stato particolarmente interessante:
«L’intelligenza artificiale sta imparando a migliorare sé stessa?»
E ho dato sostanzialmente questa indicazione:
«Scrivi un articolo sul tema…»
Carta bianca.
ChatGPT ha scritto il suo articolo.
Sono arrivato alla conclusione e ho trovato questa domanda:
«Che cosa decideremo di non decidere più noi?»
Mi sono fermato.
Quella non era semplicemente una conclusione simile a quella del nostro articolo.
Era “la” conclusione.
Nell’articolo costruito insieme avevamo discusso proprio quella formulazione e l’avevamo scelta come titolo del paragrafo conclusivo: «Che cosa decidiamo di non decidere più noi?»
Ma ChatGPT ha fatto anche di meglio.
Dopo l’articolo sviluppato in autonomia mi ha spiegato di averlo costruito da zero, sulla base della domanda e di fonti aggiornate, «senza riprendere la struttura del nostro precedente lavoro sul tema».
Del nostro precedente lavoro.
Ero uscito dal progetto. Avevo aperto una nuova chat. Non avevo fatto alcun riferimento all’articolo precedente.
Come faceva ChatGPT a sapere che esisteva quell’articolo?
A quel punto il mio esperimento era irrimediabilmente compromesso.
Ma me ne aveva regalato un altro.
Volevo studiare quanto l’interazione con una persona possa modificare ciò che scrive un’intelligenza artificiale.
Mi sono invece ritrovato davanti a una domanda preliminare che fino a poco tempo fa avremmo forse liquidato molto rapidamente:
Che cosa ricorda ChatGPT di noi?
Premessa di metodo: la descrizione che segue delle modalità di funzionamento della “memoria” di ChatGPT è opera di ChatGPT stessa, sulla base di un mio semplice prompt: «Descrivi come funziona la tua memoria, facendo anche un breve excursus storico». Il testo è stato successivamente revisionato da me per chiarire e rendere più comprensibili alcuni passaggi.
Per molto tempo una delle lamentele più frequenti sull’uso di ChatGPT e altre IA è stata questa: ogni nuova conversazione ricomincia da capo.
Puoi aver trascorso ore a spiegare chi sei, che cosa stai facendo, quali criteri stai utilizzando. Apri una nuova chat e devi raccontare tutto un’altra volta.
Questa rappresentazione aveva buone ragioni per esistere. Ma oggi rischia di descrivere un ChatGPT che non c’è più.
OpenAI dice esplicitamente che la memoria serve a permettere alle conversazioni future di partire da un contesto condiviso anziché da zero. E negli ultimi due anni il modo in cui questo avviene è cambiato profondamente.
Il punto importante è che dietro la parola memoria si nascondono fenomeni differenti.
All’inizio era quasi un taccuino
La prima memoria di ChatGPT, introdotta nel 2024, era relativamente semplice.
Potevo dire: «Ricorda che sono vegetariano», «Ricorda che insegno matematica», «Quando scrivi per me usa uno stile sintetico». ChatGPT poteva conservare queste informazioni e utilizzarle nelle conversazioni successive.
Era qualcosa di simile a un piccolo taccuino associato all’utente.
La metafora non è mia. OpenAI stessa, ricostruendo l’evoluzione del sistema, descrive quella prima memoria come qualcosa di simile a parlare con qualcuno che prende qualche appunto ma continua a dimenticare tutto ciò che non ha annotato.
Era già una memoria tra conversazioni diverse, ma piuttosto rudimentale.
E aveva un altro problema: noi cambiamo.
Un progetto termina. Una preferenza cambia. Un’attività che occupava gran parte delle nostre giornate sei mesi fa diventa irrilevante. Una decisione viene modificata.
Una memoria costituita da una collezione crescente di appunti rischia quindi di diventare non soltanto incompleta, ma vecchia.
Poi ChatGPT ha cominciato a ricostruire il contesto
Nel 2025 avviene un passaggio più importante.
ChatGPT comincia a poter utilizzare anche informazioni provenienti dalla cronologia delle conversazioni, senza che l’utente abbia necessariamente detto: «Ricorda questo».
È una differenza sostanziale.
Se per mesi discuto con ChatGPT di un progetto, non è necessario trasformare ogni informazione significativa in un’esplicita istruzione da conservare. Il sistema può ricavare dalle conversazioni precedenti elementi utili per quelle successive.
Nel 2026 OpenAI ha compiuto un ulteriore passo, introducendo una memoria che viene continuamente sintetizzata e aggiornata. L’obiettivo dichiarato è mantenere nel tempo un contesto pertinente, riducendo informazioni diventate obsolete o contraddittorie.
Quindi la metafora del taccuino comincia a funzionare male.
Forse dovremmo immaginare qualcosa di più simile a una rappresentazione continuamente aggiornata del contesto dell’utente.
Non la trascrizione della nostra storia, ma una sua ricostruzione operativa. La differenza è importante.
ChatGPT non ricorda tutto
Dire che ChatGPT ha una “memoria” può generare l’equivoco opposto a quello del passato: prima pensavamo che non ricordasse niente, ora potremmo pensare che ricordi tutto.
Non è così.
OpenAI precisa che la memoria non conserva necessariamente ogni dettaglio delle nostre conversazioni e che ciò che viene mantenuto può cambiare nel tempo. Inoltre, ciò che è disponibile non viene necessariamente utilizzato in ogni nuova risposta.
In altre parole, aver detto qualcosa a ChatGPT non significa che l’abbia conservata; e averla conservata non significa che la utilizzerà nella prossima conversazione.
La selezione avviene quindi in due momenti: nel costruire e aggiornare nel tempo il contesto sull’utente e, successivamente, nello stabilire quali elementi di quel contesto siano pertinenti alla conversazione presente.
Questo aiuta a spiegare un’esperienza apparentemente contraddittoria: a volte ChatGPT sembra aver dimenticato qualcosa di importante che gli abbiamo raccontato poco tempo prima; altre volte fa riemergere un particolare lontano che noi stessi avevamo quasi dimenticato di avergli detto.
Più che immaginare un archivio nel quale tutto viene conservato e recuperato quando serve, è quindi utile pensare a un sistema che costruisce e aggiorna una rappresentazione operativa del contesto dell’utente, cercando di mantenere ciò che può risultare utile nelle interazioni successive e di ridurre il peso di informazioni diventate obsolete o contraddittorie.
Non conosciamo nel dettaglio i criteri con cui ogni singola informazione viene mantenuta o richiamata. Il principio generale, però, è chiaro: portare nel presente ciò che del passato può essere utile, senza portarsi necessariamente dietro tutto il passato.
C’è però un aspetto importante di questa selezione: i criteri usati da ChatGPT per selezionare cosa memorizzare e cosa riusare rimangono in buona parte opachi. E non soltanto per l’utente.
Sappiamo, in termini generali, che il sistema cerca di privilegiare informazioni considerate utili e pertinenti, di mantenere continuità nel tempo e di aggiornare ciò che è diventato obsoleto. Ma questi principi generali non costituiscono una regola che permetta di prevedere che cosa accadrà a una singola informazione.
L’utente non può sapere con certezza se qualcosa che dice verrà conservato, se e quando verrà richiamato e quanto influenzerà una risposta futura. E nemmeno ChatGPT, interrogata su un caso specifico, può ricostruire dall’interno il processo che ha determinato quelle scelte: può descrivere il funzionamento generale del sistema, non osservare e spiegare passo per passo i meccanismi che hanno prodotto quella particolare selezione.
La memoria di ChatGPT presenta quindi una caratteristica importante: è selettiva, ma la selezione non è completamente prevedibile né completamente trasparente.
Possiamo quindi parlare di continuità selettiva: continuità perché una nuova conversazione non riparte necessariamente da zero; selettiva perché non tutto il passato viene portato nel presente e ciò che viene recuperato dipende da una selezione che non è completamente prevedibile né trasparente.
Questa opacità non riguarda soltanto la memoria. È una caratteristica più generale dell’interazione con questi sistemi: ChatGPT può produrre una risposta senza poter ricostruire completamente dall’interno il processo che ha portato proprio a quella risposta.
E poi sono arrivati i Progetti
Con i Progetti compare un’altra forma di continuità.
Un progetto può contenere conversazioni, file e istruzioni che appartengono allo stesso lavoro. Le diverse chat non sono necessariamente stanze isolate: ChatGPT può utilizzare le altre conversazioni e i materiali del progetto come contesto per rispondere.
È precisamente quello che rende possibile il lavoro che faccio su questo blog.
Posso discutere un articolo in una conversazione, occuparmi successivamente della sua rappresentazione grafica in un’altra, aprirne una terza per sviluppare un problema collegato e ritrovare parte del contesto costruito precedentemente.
Ma anche qui le cose sono più complicate di quanto sembri.
Esiste infatti una memoria solo progetto, nella quale il confine è relativamente netto: le conversazioni possono utilizzare altre conversazioni dello stesso progetto, ma non quelle esterne; e le conversazioni esterne non possono utilizzare quelle del progetto.
Con la memoria predefinita, invece, il comportamento può essere differente. Per gli utenti dei piani personali compatibili, le conversazioni possono, a seconda delle impostazioni, fare riferimento anche a conversazioni esterne al progetto. ChatGPT dà priorità al contesto del progetto quando ci lavoriamo dentro, ma il progetto non costituisce necessariamente una frontiera impermeabile.
Ed eccoci tornati al mio esperimento fallito.
Avevo ragionato secondo una rappresentazione intuitiva:
esco dal progetto → apro una nuova chat → ChatGPT non sa che cosa abbiamo fatto nel progetto.
Non era necessariamente vero.
Avevo cambiato stanza.
Non avevo necessariamente cancellato ciò che il mio interlocutore portava con sé.
Non c’è soltanto ciò che ChatGPT ricorda
La situazione diventa ancora più interessante se allarghiamo ulteriormente lo sguardo.
Oggi una risposta può essere influenzata da fonti differenti: la conversazione che stiamo svolgendo, informazioni provenienti da conversazioni precedenti, memoria, istruzioni personalizzate, file disponibili e, quando sono collegate e pertinenti, anche informazioni provenienti da applicazioni esterne. Le possibilità effettive dipendono dal piano, dalle impostazioni e dalle funzioni disponibili.
Il prompt, quindi, non è necessariamente tutto ciò che ChatGPT sa nel momento in cui risponde.
Questa constatazione ha conseguenze molto più interessanti della semplice comodità di non dover ripetere ogni volta «sono vegetariano».
Quando due persone scrivono esattamente lo stesso prompt, non è detto che stiano facendo esattamente la stessa domanda allo stesso sistema nelle stesse condizioni.
ChatGPT può infatti rispondere tenendo conto non soltanto delle parole contenute nel prompt, ma anche di informazioni ricavate dalle precedenti interazioni con quella persona.
E più questa storia di interazioni diventa lunga e articolata, più può influenzare la risposta che riceviamo.
Nel mio caso la cosa è particolarmente evidente. Se per mesi discuto con ChatGPT di intelligenza artificiale e scuola, respingo certe semplificazioni, insisto su determinate distinzioni, sviluppo alcuni concetti, costruisco articoli attraverso decine di revisioni, quel passato può diventare contesto per interazioni successive
Tutto questo ci dice che, rispetto all’esperimento a cui avevo accennato all’inizio dell’articolo, più ChatGPT diventa utile per me perché mi conosce, meno è neutro un esperimento nel quale voglio osservare che cosa avrebbe prodotto senza conoscermi.
La personalizzazione, che normalmente è un vantaggio, diventa contaminazione sperimentale. È esattamente quello che mi è successo.
E più questa storia di interazioni diventa lunga e articolata, più può influenzare la risposta che riceviamo.
Ma allora ChatGPT ha una memoria di me?
Sì, purché non attribuiamo troppo rapidamente alla parola memoria il significato che possiede quando parliamo di una persona.
Non c’è necessariamente un piccolo archivista digitale che conserva ordinatamente la nostra autobiografia e, prima di risponderci, va a cercare il fascicolo appropriato.
C’è un sistema che può selezionare, sintetizzare, aggiornare e rendere disponibile del contesto precedente per rendere più pertinente l’interazione presente. OpenAI descrive il nuovo sistema proprio in termini di sintesi della memoria orientata a tre caratteristiche: aggiornamento, continuità e pertinenza.
Mi sembra una distinzione importante.
La memoria umana è parte della nostra esperienza: ricordare significa anche ricostruire il nostro passato dal presente, dimenticare, deformare, attribuire significati.
La memoria di ChatGPT è una funzione del sistema.
Ma dal punto di vista dell’utente produce un effetto sorprendentemente concreto:
la conversazione di oggi può essere influenzata da quella di ieri.
E questo modifica profondamente il rapporto con lo strumento. Non interagiamo più necessariamente con un’IA che ci incontra ogni volta per la prima volta, ma con un sistema che può portare nella conversazione presente qualcosa della storia costruita con noi.

